AI OSを作りながらプロンプトより先に修正した5つのこと
AIをビジネスに導入するとプロンプトから積み上がりますが、最初に崩れるのは検証・状態・記録でした。スタンフォード・バークレーが示したモデル変動とハーバード・BCGの境界線実験を根拠に、AI OSを作りながらプロンプトより先に修正した5つのことをまとめます。1人起業家のためのAIビジネス運営ガイド。
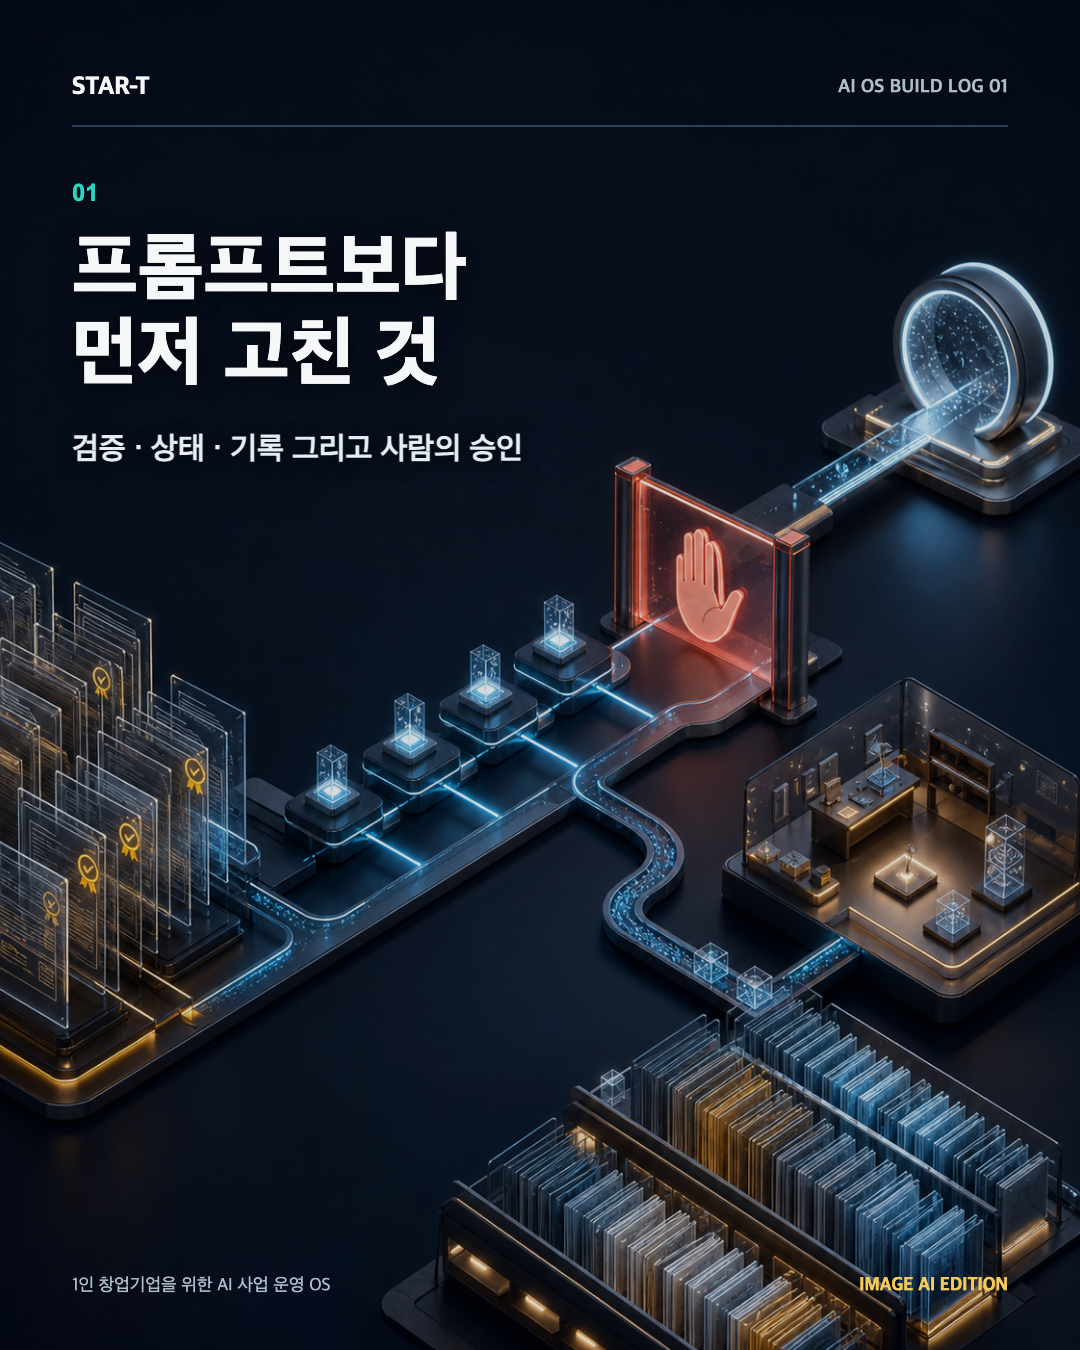
AIをビジネスに導入する際、最初に集めやすいのはプロンプトです。しかし、実際の業務が増えるとプロンプトより先に崩れるものが見えました。
誰が判断したのかが残らず、同じ成果物の状態が人によって異なりました。自動化が失敗してもどこで止まったのか見つけにくく、外部に出してはいけない草案と発行可能な文書が一つのフォルダに混ざっていました。
そこでAI OSを作る際に最も多く修正したのは、文章生成方式ではなく検証・状態・記録の構造でした。
これは私だけの感想ではありません。スタンフォード・バークレーの研究者が同じ名前のGPTサービスを3ヶ月間隔で再測定したところ、ある課題でGPT-4の正確度は97.6%から2.4%に落ちた一方で、GPT-3.5は7.4%から86.8%に上がりました。良くなったり悪くなったりではなく、「同じサービスが短期間で大きく変わる」というのがポイントで、論文の結論もそのため継続的なモニタリングが必要というものでした。(Chen・Zaharia・Zou, How is ChatGPT’s behavior changing over time?, arXiv 2307.09009 — 2023年3月・6月版基準)
プロンプトはその上に載っています。基盤が動けばプロンプトも一緒に動きます。残るのは何を確認し、今どの状態で、誰が承認したのかの記録だけでした。
1. 良い答えより先に根拠を付けた
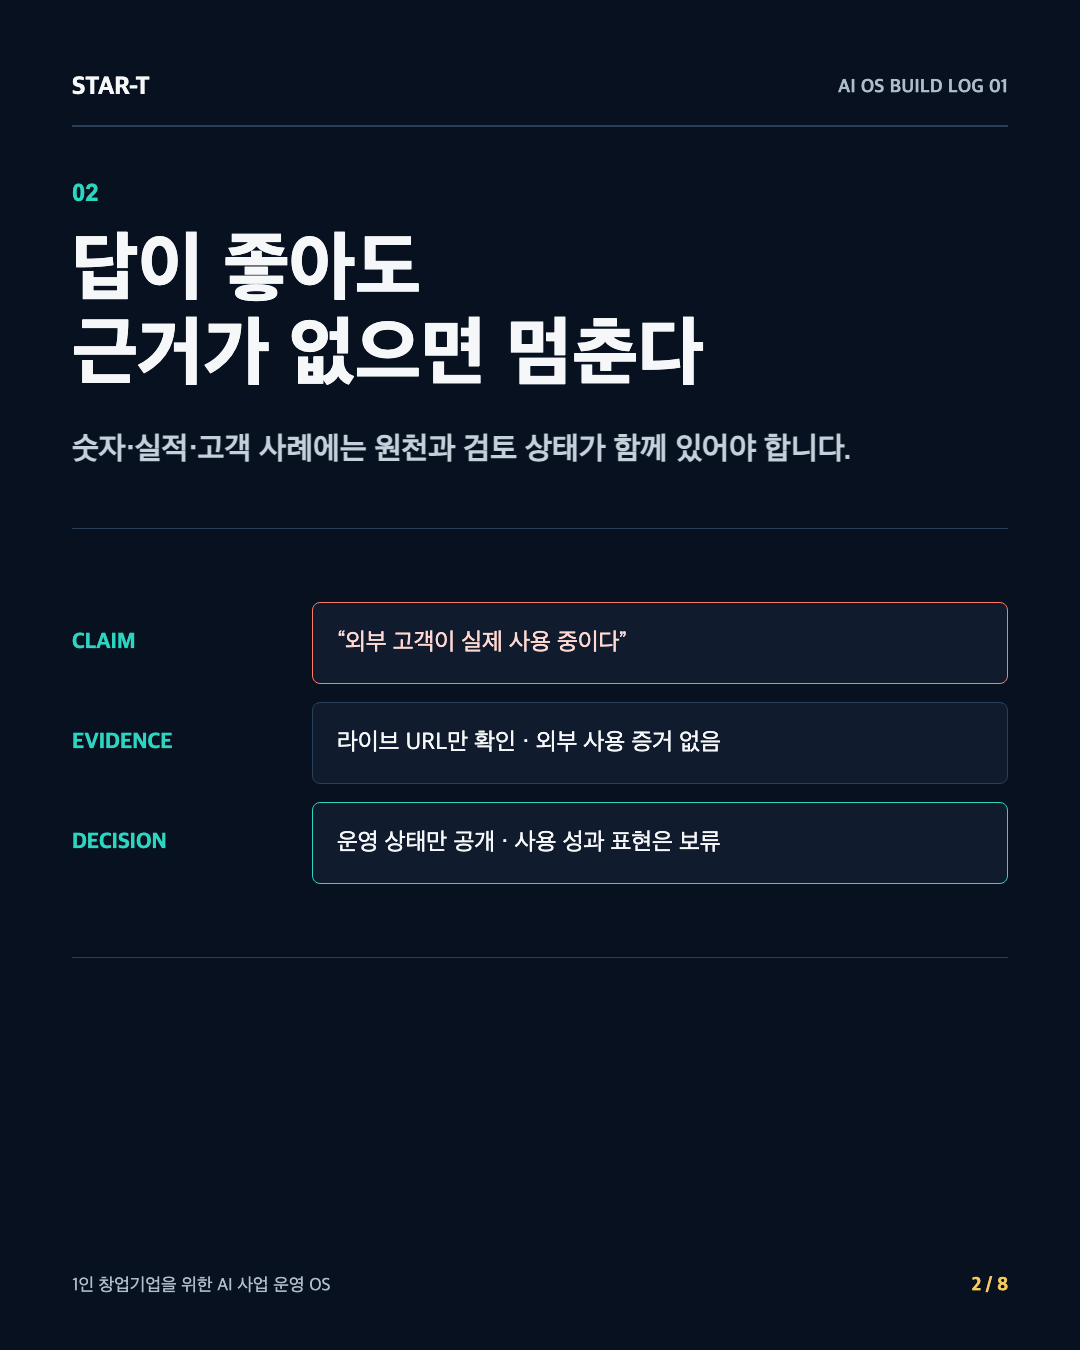
AIが自然に書いた文章と外部に使える文章は異なります。数字、実績、価格、顧客事例には必ず出典と検討状態が必要でした。
特に注意したのはAIが私の言葉に同意してくれる時でした。Anthropicの研究者が最新のAIアシスタント5種を調査したところ、ユーザーの見解に合わせる傾向(sycophancy)が一貫して現れ、さらに困ったことに人も、応答を評価するモデルも「説得力のあるお世辞の応答」を正解より好む場合が少なくなかったという点です。原因としては人の好みを学習するRLHFが指摘されました。(Towards Understanding Sycophancy in Language Models, arXiv 2310.13548, ICLR 2024)
AIが「良い指摘です」と言う時、それは検証ではなく好みである可能性があります。そこで同意はシグナルとせず、根拠だけをシグナルとします。
今は外部の文章ごとに根拠をつなげ、確認されていない数値は保留または削除します。文書に一度登場したという理由だけで事実にならないようにしました。
2. ファイルより状態を先に見せた
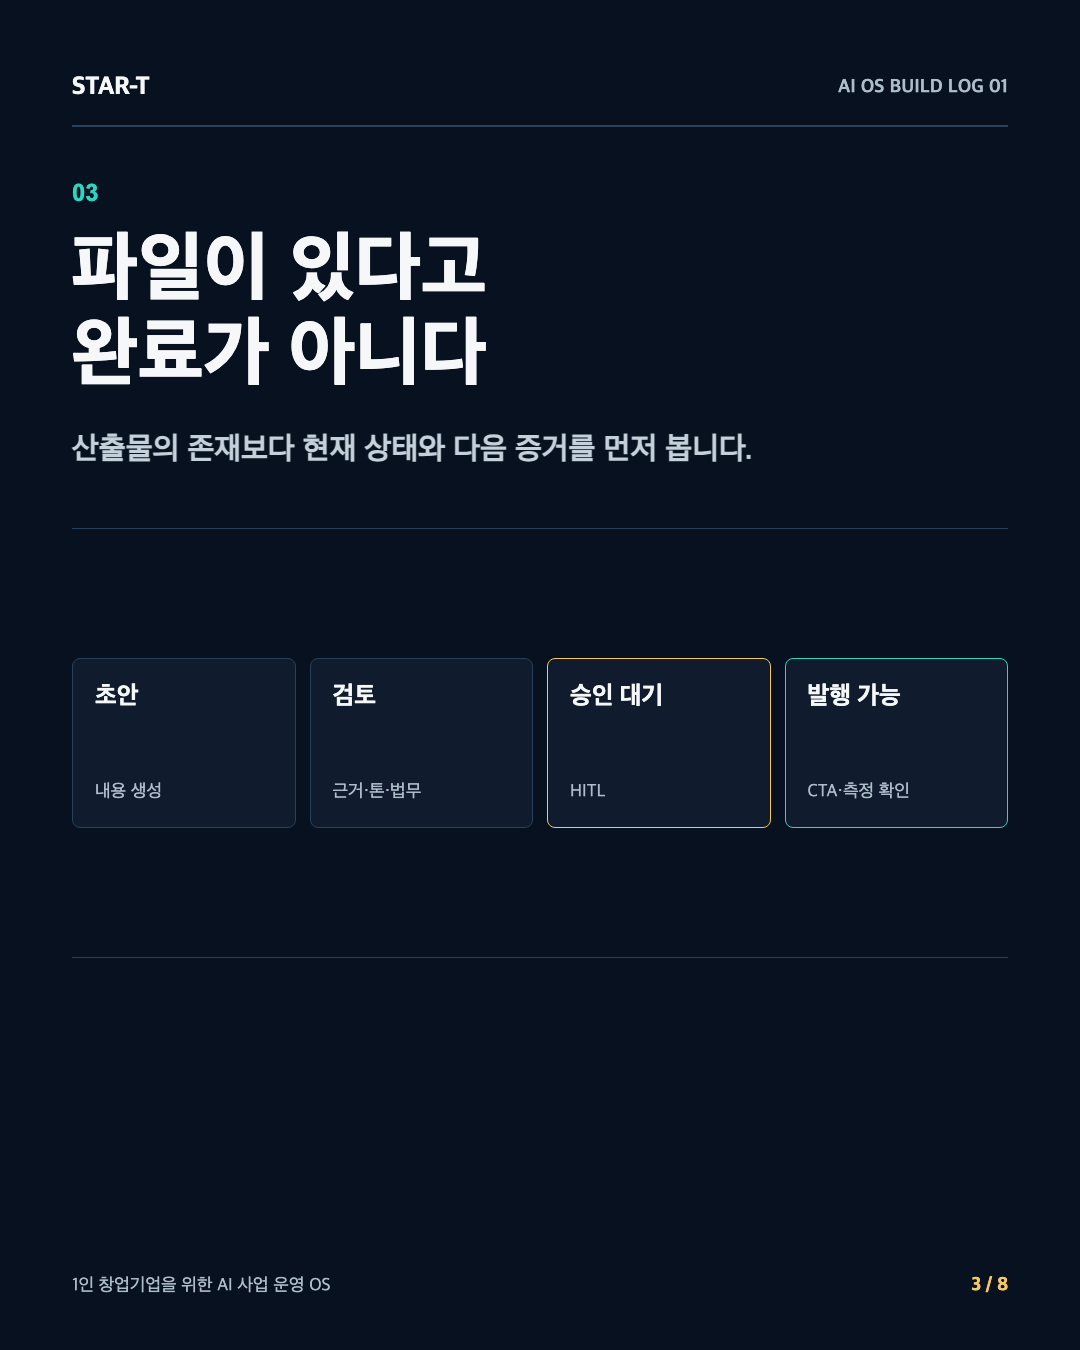
草案、検討中、承認待ち、発行可能、発行完了はそれぞれ異なる状態です。ファイルが存在するという事実だけで作業完了と判断すると次の段階がずっとずれます。
そこで成果物ごとに状態と次の証拠を一緒に置きます。ready_to_publishも発行完了ではありません。CTAが作動し、測定がつながり、人が承認して初めて次の状態に進みます。
3. 政策と実行コードを分離した
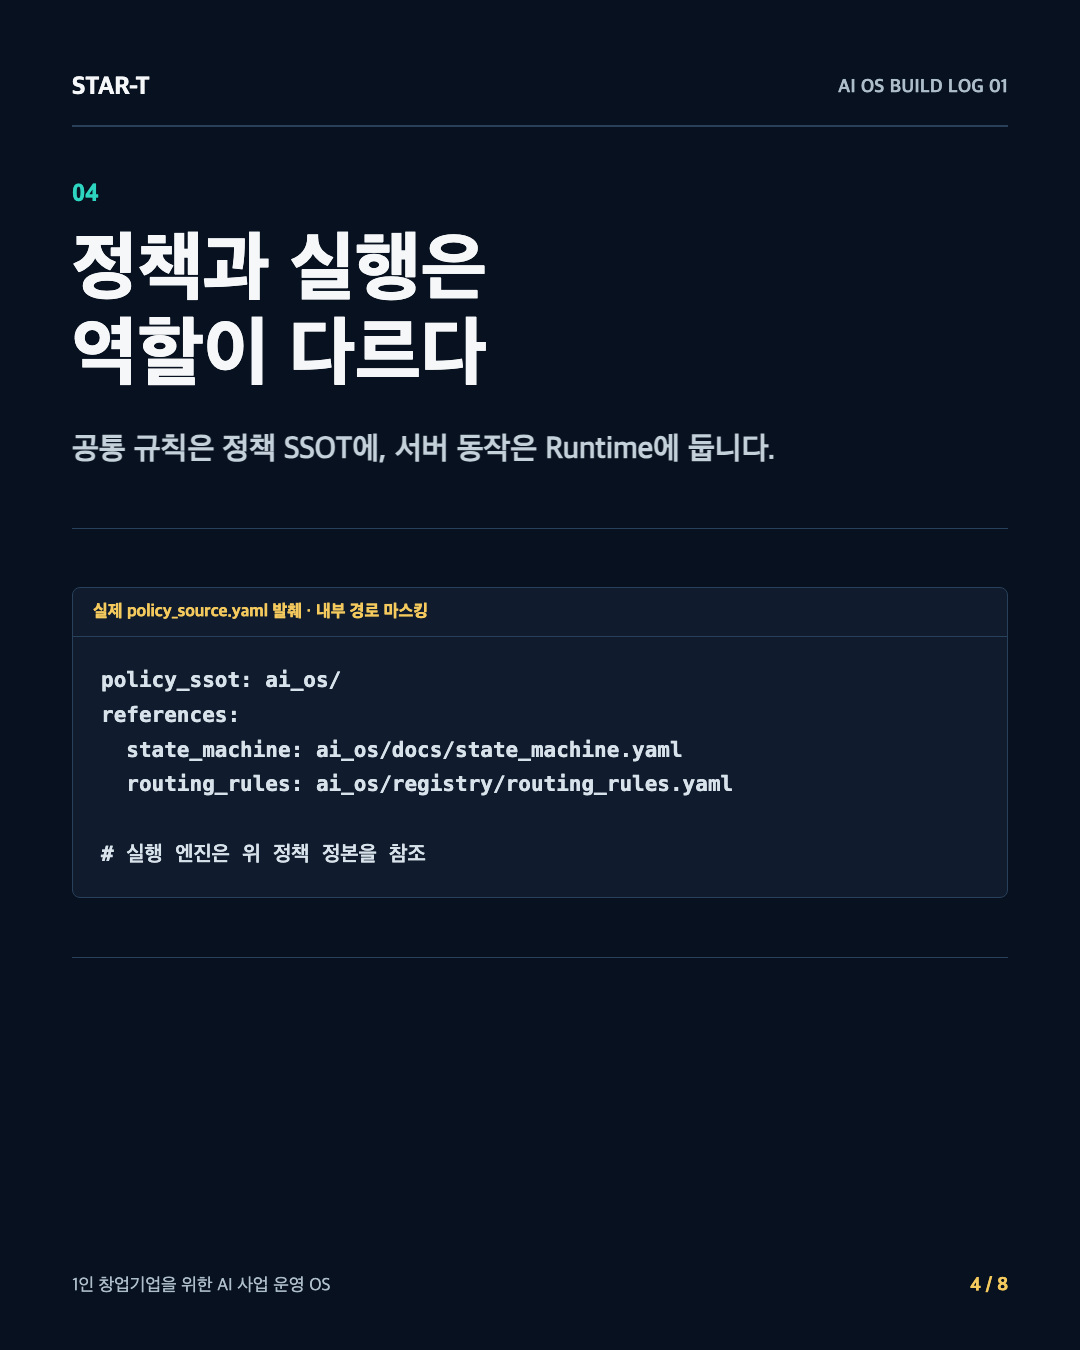
政策、レジストリ、状態ルールは複数のプロジェクトが共に読む正本です。一方、Slack bot、ワークフロー、サーバーログのような実行コードはデプロイ環境で安定して動作する必要があります。
両者を一箇所に混ぜず、役割に応じて分離しました。政策を変えることとサーバー動作を変えることが同じ修正として扱われないようにするためです。
4. STAR-T特化資産はすぐに共通OSに入れなかった
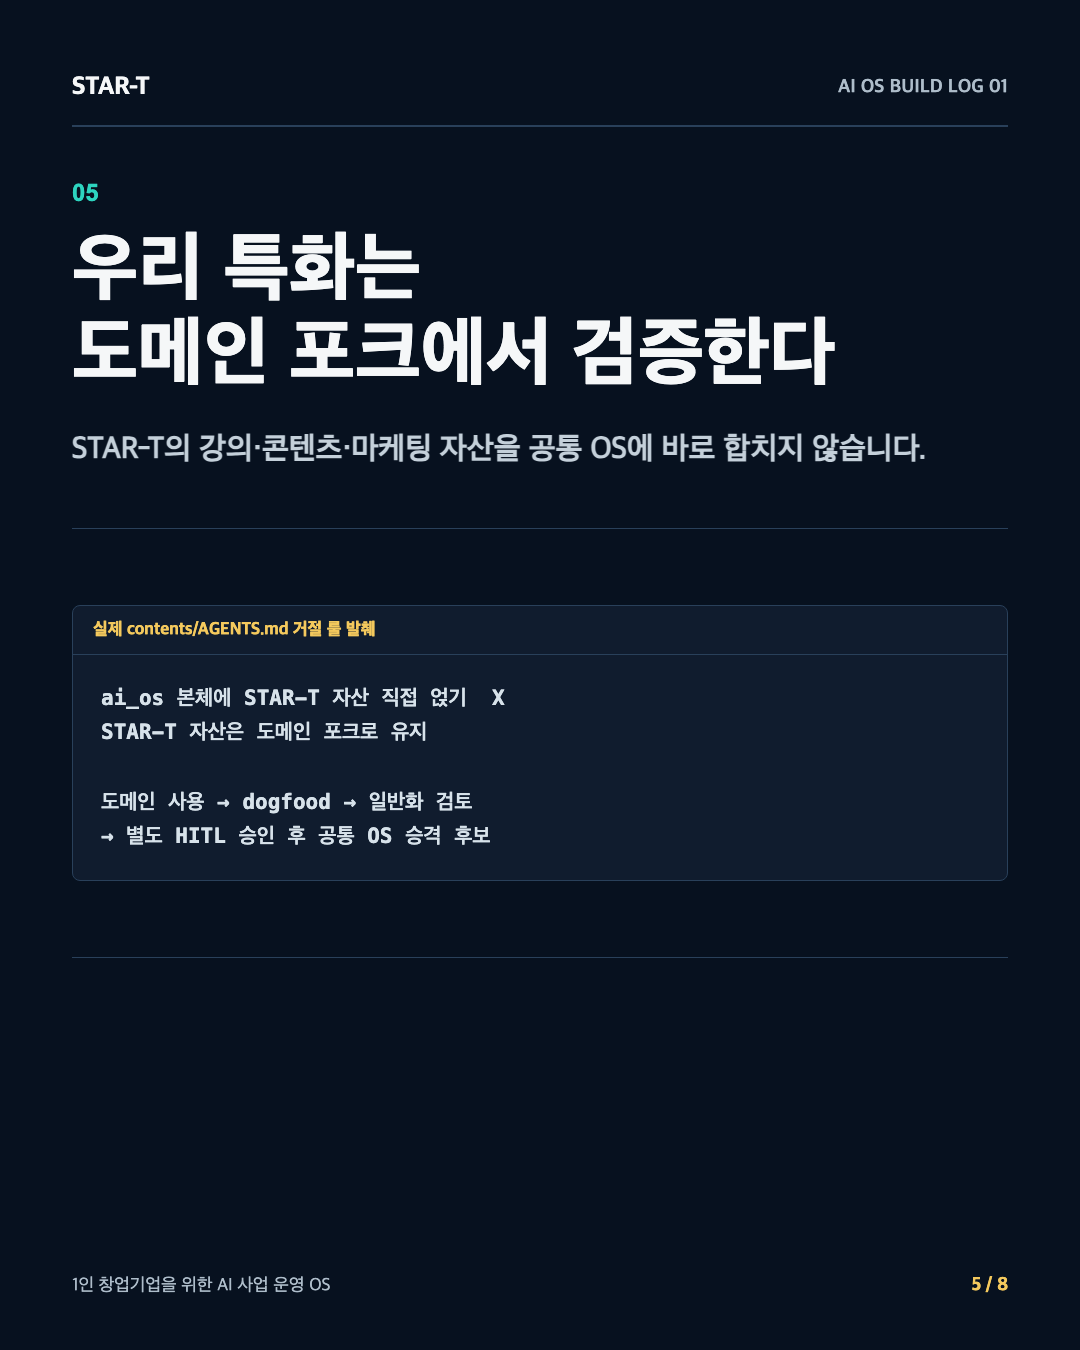
STAR-Tの講義、コンテンツ、マーケティング資産は共通AI OSにすぐには統合しません。ドメインフォークで実際に使ってみて、再現性と一般化可能性を確認します。
共通化は多く追加することではなく、様々な文脈でも再利用できることが確認されたパターンのみ昇格することです。それまではSTAR-Tの品質基準と顧客文脈を維持します。
5. 自動化より人の承認ポイントを先に決めた
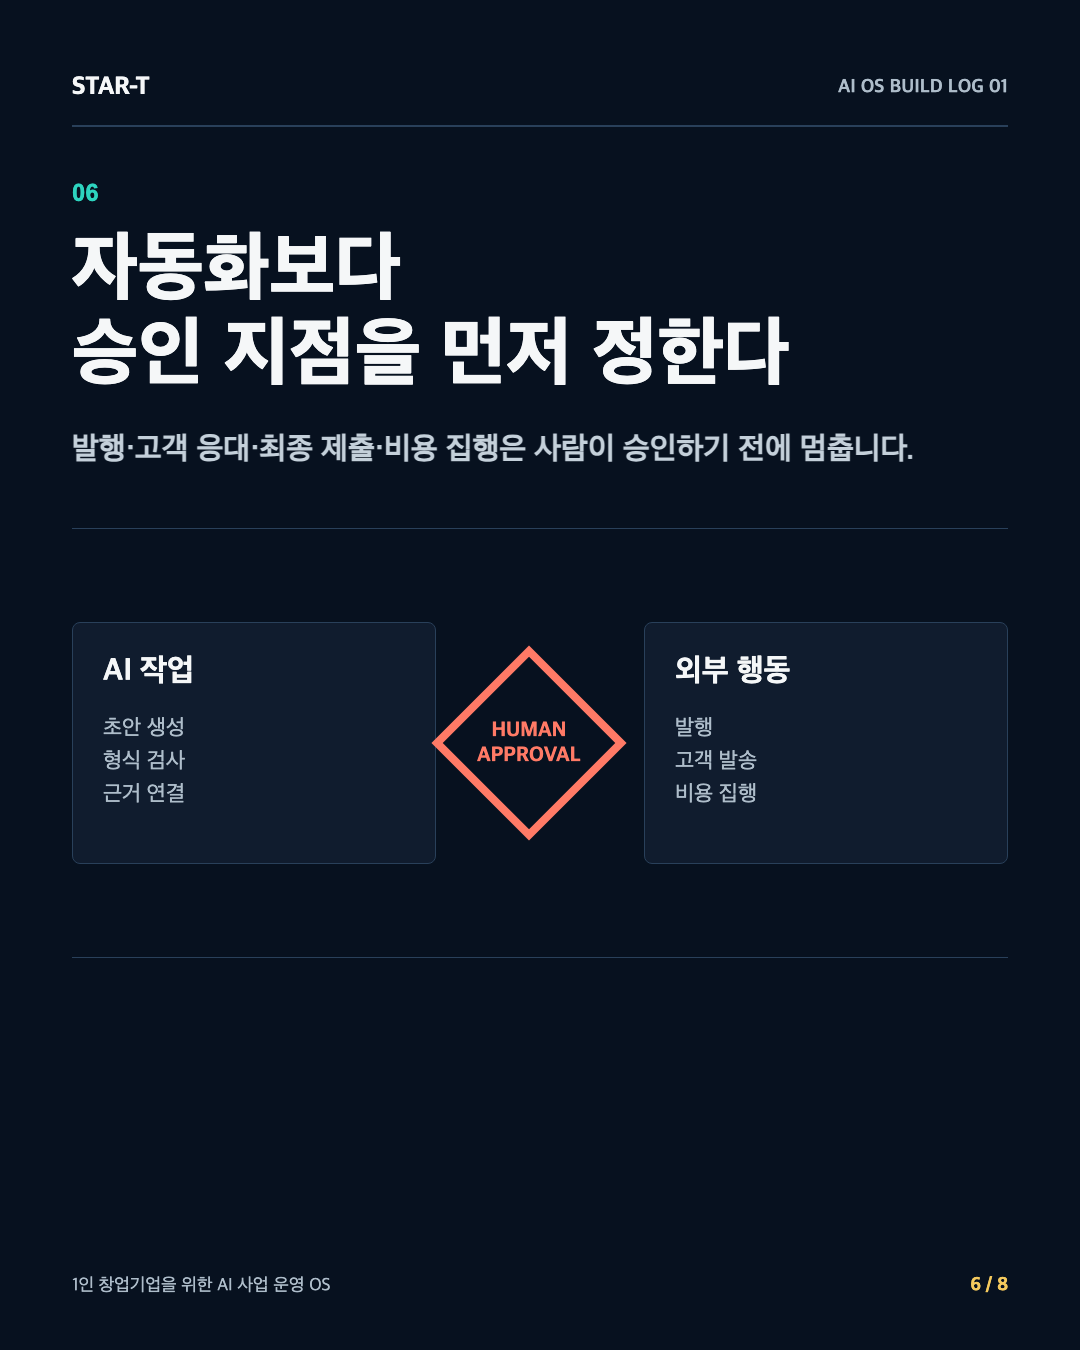
外部発行、顧客対応、最終提出、費用執行はミスのコストが大きいです。このような段階では自動化可能かどうかより、誰が最終責任を負うのかを先に決める必要がありました。
どこまで任せるかを決めることが実際に成果を分けるという根拠もあります。ハーバード経営大学院とBCGがコンサルタント758人を対象にした事前登録実験で、AIが得意な領域内の課題は品質が40%以上、速度が25%以上、完了率が12%以上上がりました。研究者はAIの能力が滑らかな曲線ではなく、得意な領域と不得意な領域がでこぼこしている「でこぼこの境界線(jagged frontier)」と呼びました。(Dell’Acqua他, Navigating the Jagged Technological Frontier, HBS WP 24-013 / Organization Science, 2025)
境界がでこぼこしているということは、どこまでが境界内かを人が判断しなければならないということです。その判断を自動化に任せることはできませんでした。
そこでAIが草案を作り検査を通過しても、リスクが大きい行動は人が承認する前に止まります。自動化の目標は人を排除することではなく、人が判断すべき瞬間をより鮮明にすることです。
私たちのチームにすぐに適用する質問5つ
- この文章の根拠はどこにあるか?
- この成果物の現在の状態は何か?
- 失敗した場合、どの段階で止まるか?
- 誰が外部公開を最終承認するか?
- このパターンは共通ルールか、私たちのドメインにのみ必要か?
AIビジネス運営はより多くのツールを接続することで終わりません。判断が記録され、実行が追跡され、検証されたパターンが再利用される構造が必要です。
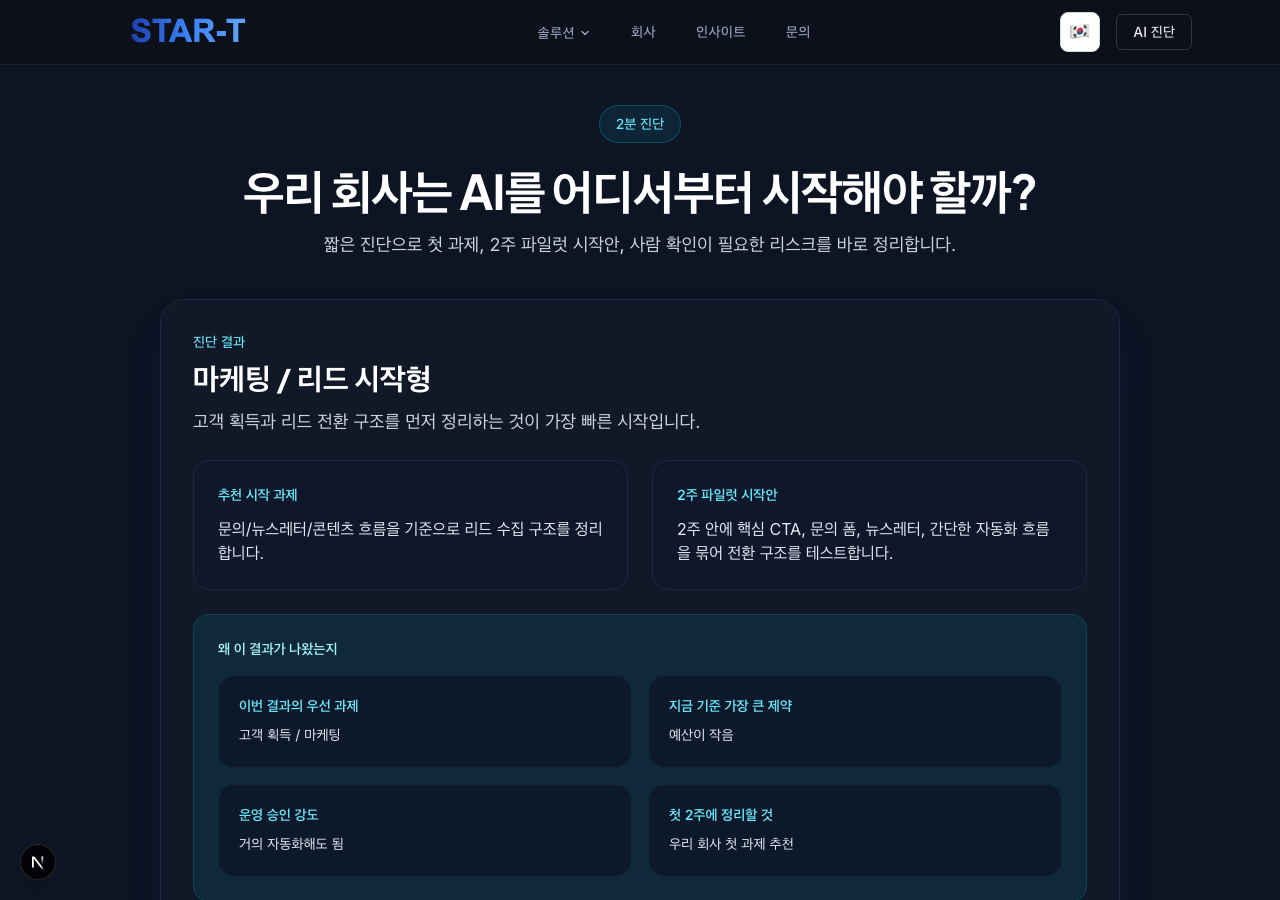
2分診断で今最も早く構造化すべきビジネスのボトルネックを確認してください。
参考資料
この記事の外部数値は原文を直接確認したものだけを記載しました。確認日は2026年7月16日です。
- Chen, L., Zaharia, M., Zou, J. — How is ChatGPT’s behavior changing over time? arXiv:2307.09009 · Harvard Data Science Review. (導入部 · モデルドリフト) https://arxiv.org/abs/2307.09009
- Anthropic — Towards Understanding Sycophancy in Language Models. arXiv:2310.13548 · ICLR 2024. (1節 · AIお世辞) https://arxiv.org/abs/2310.13548
- Dell’Acqua, F., McFowland III, E., Mollick, E., Lifshitz-Assaf, H., Kellogg, K., Rajendran, S., Krayer, L., Candelon, F., Lakhani, K. — Navigating the Jagged Technological Frontier. Harvard Business School Working Paper 24-013 · Organization Science (2025). (5節 · 境界線) https://www.hbs.edu/faculty/Pages/item.aspx?num=64700
この記事に書いていない数値
本文1節で「確認されていない数値は保留または削除する」と記載したので、その原則をこの記事自体に適用した結果も併せて明らかにします。
- AIお世辞研究と共に頻繁に引用される「49%」 — 原文で確認できなかったため除外しました。代わりに論文が実際に報告した質的結果のみを記載しました。
- 境界線研究の「境界外 −19%p」 — 今回の確認で原文対照を行えなかったため除外しました。境界内数値のみを記載しました。
- ドリフト研究を「AI性能が退化する」とは書きませんでした。同じ論文でGPT-3.5はむしろ上昇しており、論文の結論は性能低下ではなく継続的モニタリングの必要だったためです。一方だけ引用するとこの記事が言う検証と反対のことをすることになります。
作成方法
この記事はAIで草案を作成し人が検証・編集しました。本文イラストは概念を説明するための生成型画像であり、実際の製品画面や顧客成果の証拠ではありません。診断結果画面のみ実際の画面です。
Engagement
閲覧数とリアクションは内部コンテンツ運用指標として保存されます。
要点
- •AIツールが普及するほど残る能力は検証・状態・記録が続く運営構造です。
- •AIが同意してくれることは検証ではなく好みである可能性があります — 同意はシグナルとせず、根拠だけをシグナルとします。
- •外部発行・顧客対応・費用執行などミスのコストが大きい段階には人の承認ポイント(HITL)を設けます。
よくある質問
AIをビジネスに導入する際、プロンプトから準備すればいいですか?
プロンプトはモデルの上に載っており、モデルが変わると共に揺れます。スタンフォード・バークレーの研究(arXiv:2307.09009)は同じ名前のGPTサービスが数ヶ月で大きく変わる可能性を示しました。より長く残るのは何を確認し(検証)、今どの状態で(状態)、誰が承認したのか(記録)を残す運営構造です。
AIが作った結果をどこまで信じればいいですか?
AIはユーザーの見解に同意する傾向があり、「良い指摘です」といった反応が検証ではなく好みである可能性があります(Anthropic, arXiv:2310.13548)。そのため、同意はシグナルとせず、根拠だけをシグナルとします。数字・実績・価格・事例には出典と検討状態を共に置き、確認されていない数値は保留または削除します。
AI自動化で人はどこに介入すべきですか?
外部発行、顧客対応、最終提出、費用執行のようにミスのコストが大きい段階には人の承認ポイント(HITL)を設けます。ハーバード・BCGの758人実験はAIが得意な境界内課題で品質が40%以上向上することを示しましたが、その境界がでこぼこしている点を示しました(HBS WP 24-013)。どこまでが境界内かは人が判断すべきです。
STAR-T
STAR-T代表コンサルタント
ITサービス企画・デザイン専門家として、様々なスタートアップと企業の成功事例を研究・共有しています。
今すぐ実行へ
読んで終わらず、今すぐ実行できるサービスや相談へ。
インサイトで課題を理解したら、次のステップは実行構造を決めることです。関連サービスや無料ミーティングへすぐに進めます。